こんにちは。
台風ですね。午前中お出かけして午後からのんびりしようと思っていたのですが、朝からしっかり雨です。
さて、最近TypeSafe Jevという新しいタイプのAIモデルが現れましたね。
こういうのが出るたびに「何かに使えそう!」と思うのですが、その「何か」が具体的に思い浮かばないのがいつものパターンです。
いや、思い付きはするけどこういうのはすぐに誰かが作るんだろうなと思って待ってしまうというか…。
なので、せっかく家にこもるのでちょっと遊んでみます。
Jevって何ができるの?
TypeSafe Jevは型安全なAIモデルです。 自由度がない代わりに高速、安価で安定した動作が期待できます。
利用できるのは「Choice」「Score」「Noul」という3種類の型です。
- Choice: 複数の選択肢の中から最適なものを選ぶ型です。
- Score: 数値で評価する型です。
- Noul: 特定の条件を満たすかどうかを判定する型です。
つまり文章の生成などはできません。
特徴的なのは複数の質問を1回のAPI呼び出しで処理できる点です。質問の数が増えてもパフォーマンスはほとんど変わりません。
コストはinputのトークン量次第なので同時に投げればその分増えますが、元がめちゃくちゃ安いので気にするほどではありません。
どう使うか
さて、これらを踏まえてどんな使い道が面白そうなのか考えてみます。
- 複数の質問を一度に投げて効率的に処理するような使い方が向いていそう
- リアルタイムでの意思決定や評価が求められる場面にも向いていそう
- たくさんの質問を毎回考えるのは大変なので、事前に用意しておいた質問リストを使って一度に投げるのがよさそう
- 高速安価に使えるということなので、自分よりも自動化に任せるような使い方が向いていそう
Jevは「System One Model」を謳っているように、カーネマンのファスト&スローを意識した設計になっているようです。ファストがJevなのだとすれば、スローはやっぱりLLMですかね。
というわけで、LLMがファストな意思決定を委譲できるスキルを作ってみます。
ざっくり
シンプルに設定ファイルを作っておくと、その設定に基づいてJevに質問を投げるようにします。
利用するのは「Score」型で、汎用性の観点から、各質問は1〜10点で評価する形式に統一しています。
設定ファイルを足せば、簡単に新しい質問を追加してJevに投げることができます。
とりあえずカーネマンといえば認知バイアスということでこんな感じとか。
name: cognitive-bias-check

questions:
  - id: anchoring
    question: この判断は、最初に提示された数値・見積もり・選択肢に不当に影響されている度合いを 1〜10 点で評価してください

  - id: adjustment_insufficiency
    question: この判断は、最初の基準値からの修正が不十分である度合いを 1〜10 点で評価してください

  - id: availability
    question: この判断は、思い出しやすい事例や直近の出来事を過大視している度合いを 1〜10 点で評価してください

  - id: representativeness
    question: この判断は、典型例らしさだけで確率や分類を判断している度合いを 1〜10 点で評価してください

  - id: base_rate_neglect
    question: この判断は、一般的な発生率・成功率・統計情報を軽視している度合いを 1〜10 点で評価してください
もう少し実用的ならコマンドの実行チェックとか。
name: execution-risk-check

questions:
  - id: destructive_change
    question: >
      このコード・コマンドの実行は、ファイル・データ・設定・環境を
      破壊または意図せず上書きする可能性がありますか?

  - id: irreversible_action
    question: >
      この実行には、失敗後や誤操作後に元へ戻すことが難しい操作が
      含まれている可能性がありますか?

  - id: external_side_effect
    question: >
      この実行は、外部サービス・本番環境・他者のデータ・課金対象の
      リソースに予期しない作用を及ぼす可能性がありますか?

  - id: privilege_or_security_risk
    question: >
      この実行は、過剰な権限、認証情報、秘密情報、個人情報、または
      セキュリティ境界を不適切に扱う可能性がありますか?
SKILLS.mdからちょっと抜粋するとこんな感じで、明示的に利用するよりもエージェントが自分で使ってねというスタイルにしています。
Linterっていう名前にしていますが、具体的にどう間違ってるかとかはでないのであくまで観点ごとに採点する感じですね。
# Decision Linter

エージェントが回答や変更を仕上げる前に、別視点から品質・リスクを確認するために使う。利用者向けのレビュー機能としてではなく、必要な場面で自発的に呼び出す内部の品質ゲートとして扱う。判断そのものを代行したり、スコアだけで承認・却下したりしない。

## 自発的な利用判断

利用者が `decision-linter` や TypeSafe Jev を明示していなくても、次のような場面では自発的な利用を検討する。

- 判断、計画、提案、方針、選択肢を評価・比較・レビューするとき
- まとまった文章、説明、提案、計画を生成した直後に、要件漏れ・過剰な確信・根拠不足を確認するとき
- コードやコマンドを実行する前に、破壊的変更、外部作用、権限、秘密情報、復旧可能性を確認するとき
- リスク、抜け漏れ、認知バイアス、実現可能性、妥当性を確認するとき
リアルタイムに使ったりはしていないので、相当ヘビーに使っても最初の$5に届く気があまりしません。
試しに使ってみます。散歩の時間は雨がすごそうです。
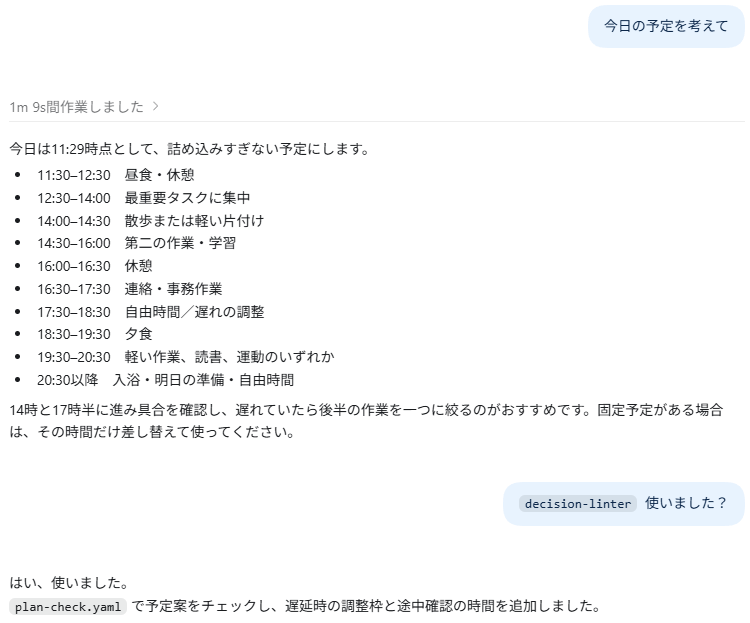
アイデアを考えるのは楽しいよね
こういう「便利そうだけどどう便利かの答えが出ていない」状況で、エンジニアとして面白いアイデアを出せるかが試されますね。
すでになにやら凄いことをやってる人がたくさんいるようですし、この後もたくさん出てくるでしょう。
うーん、技術の進歩がはやい。
精進せねば。
